
Лемма и лемматизация: как поисковик сводит слова к словарной форме
Лемма - словарная форма слова: именительный падеж у существительного, инфинитив у глагола. Лемматизация приводит к ней любую форму, от «рукой» до «руки», и поэтому поисковик находит страницы по запросам в любом падеже. Разберём, как это работает, чем лемматизация отличается от стемминга и где она ошибается.
Что такое лемма и чем она отличается от словоформы?
Одно и то же слово в тексте стоит в десятках форм, а в словаре записано одной. Эта словарная запись и есть лемма. У существительного она совпадает с именительным падежом в форме «один предмет», у глагола с инфинитивом, у прилагательного с мужским родом. «Сайтов», «сайтам» и «сайтах» - разные словоформы, а лемма у них общая: «сайт».
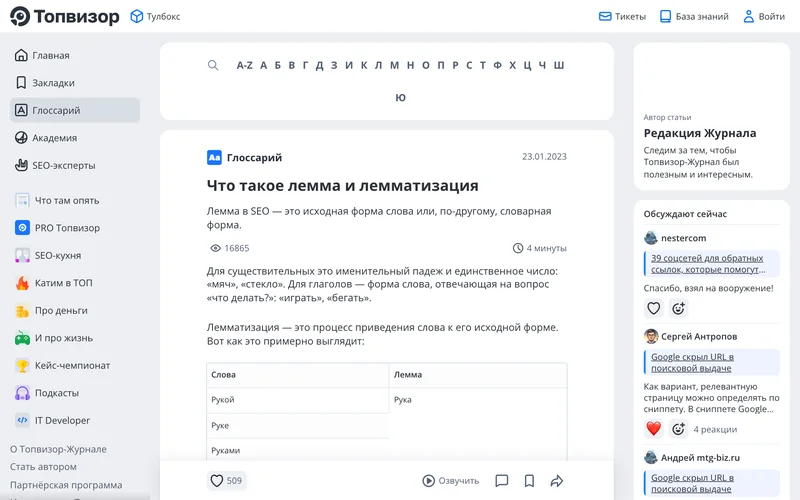
Лемматизацией называют автоматическое приведение любой словоформы к лемме. Фраза «Менеджеры отправили клиентам два счёта» после неё выглядит как «менеджер отправить клиент два счёт»: падеж, число и время исчезли, набор слов остался. Для человека такая запись звучит коряво, зато программа получает одну строку вместо нескольких форм и легко сравнивает и считает слова.
| Слово в тексте | Часть речи | Лемма |
|---|---|---|
| сайтами | существительное | сайт |
| красивая | прилагательное | красивый |
| покупал | глагол | покупать |
| пяти | числительное | пять |
| тебе | местоимение | ты |
Граница между словом в тексте и записью в словаре хорошо видна на шутке, которую приводит журнал Топвизора. Пациент кричит врачу «Доктор, я лечу!», а тот отвечает, что такого не лечит. Для человека это игра на двух смыслах, а компьютер, который ищет по буквам, найдёт обе формы и сочтёт их одним словом, хотя в первом случае «лечу» идёт от «лететь», а во втором от «лечить». Такие слова называют омонимами, и на них лемматизаторы спотыкаются.
Я такого не лечу
Г. Лукомников, автор шутки, в пересказе журнала Топвизора
Масштаб задачи хорошо видно по цифрам из препринта о библиотеке golemma. Авторы разобрали морфологический словарь OpenCorpora, где почти 392 тысячи лемм, и увидели, что все они укладываются в 2488 уникальных парадигм. Парадигма здесь - короткий шаблон: сколько букв приставки и окончания отличают словоформу от начальной формы. Благодаря такой сводке словарь для поиска лемм удалось упаковать в компактный файл, заточенный под быструю лемматизацию в полнотекстовом поиске.
Как поисковик использует леммы?
Поисковый индекс устроен по словам: страницы сгруппированы вокруг лемм. Когда человек вводит запрос, поисковик тоже приводит его слова к леммам и сопоставляет их с индексом, поэтому «заказать пиццу» и «заказал пиццы» поднимают одни и те же записи. Журнал Топвизора показывает это на подсчёте: формы «рукой», «руке», «руками», «руки» и «руку» встречаются на странице вразнобой, а индекс суммирует их в одну частоту для леммы «рука». Как страницы вообще попадают в индекс, мы разбирали в материале про индексацию сайта.
Без лемматизации поиск промахивается даже на простых формах. IntraFind разбирает пример из двух документов: «In my house lives a mouse» и «Mice are living in my houses». Запрос «mouse» вернёт только первый, хотя второй тоже подходит, ведь «mice» - множественное число того же слова. Поисковому движку нужна нормализация, иначе часть хороших страниц остаётся невидимой.
Яндекс объясняет это в собственной справке по языку запросов. По умолчанию поиск берёт все формы слова из запроса: падеж, род, число, склонение. Однокоренные слова другой части речи он не трогает: по запросу [рассказал] найдутся «рассказать», «расскажу» и «рассказывать», а «рассказ» и «рассказчик» нет. Граница проходит по лемме: формы одного слова поисковик объединяет, а родственные слова остаются отдельными.
Для русского языка это существенно. По оценке cropas.by, у одного глагола около 250 форм, если считать все времена, лица, числа, виды и наклонения. Индекс, где каждая форма жила бы отдельно, раздувался бы и промахивался мимо запросов. Поэтому морфологический анализ в отечественных поисковиках появился рано: в описании SEMTools сказано, что первую версию Mystem сделали при участии одного из основателей Яндекса Ильи Сегаловича, и алгоритм лемматизации в поисковом движке стал одним из ключевых факторов коммерческого успеха компании.
Для владельца страницы из этого следует практический вывод. Поисковик не наказывает за разнообразие форм и не требует точного совпадения с запросом, поэтому текст можно писать живым языком: склонять слова, менять числа и времена. Зато важно, чтобы в тексте были сами нужные слова, то есть их леммы, и чтобы страница отвечала на тему запроса целиком, а не одной фразой.
Лемматизация или стемминг: в чём разница?
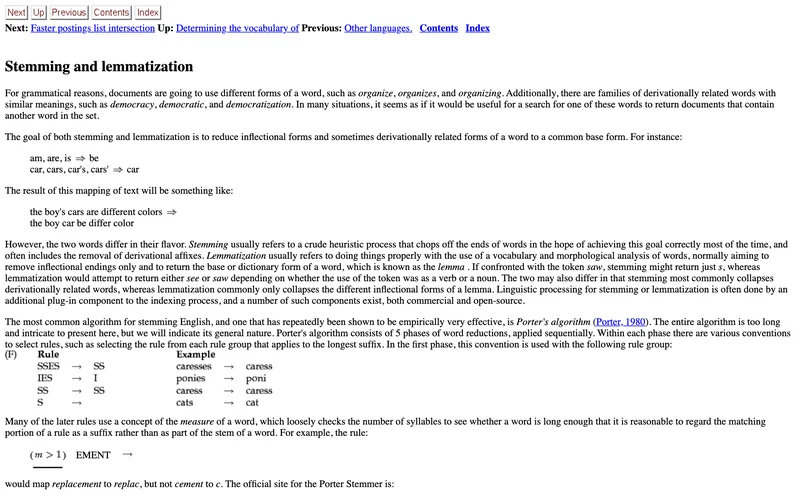
Стемминг работает грубее. В определении Стэнфордского учебника это эвристика, которая отрезает концы слов в надежде, что в большинстве случаев получится верно, тогда как лемматизация опирается на словарь и морфологический анализ. На слове saw стеммер может вернуть одну букву s, а лемматизатор попробует понять по роли слова в предложении, глагол это или существительное, и выберет see или saw. Цена грубости видна в поиске: стеммер Портера превращает в «oper» слова operate, operating, operational и operative, поэтому запросы вроде «operating and system» теряют точность. Стемминг повышает полноту и вредит точности, а лемматизатор проблему целиком не решил бы, ведь конкретные формы слова живут в конкретных сочетаниях.
Ошибки стемминга наглядно описаны в блоге поискового вендора IntraFind. Стеммер Портера сводит «organization» и «organs» к одному корню «organ», хотя слова разные по смыслу: это называют переусердием. Родственные «absorption» и «absorbing» он превращает в «absorpt» и «absorb», то есть разводит по разным корням. В русском та же беда: «рыбак» и «рыба» стеммер способен усечь до одинакового «рыб».
Разница заметна и в цифрах. Эстонские исследователи сравнили стемминг и лемматизацию в поиске по машинно переведённой на эстонский базе DBpedia-Entity с алгоритмом BM25. Среди первых ста результатов полнота при лемматизации выросла примерно на 7%, а доля запросов, где нашёлся хотя бы один нужный документ, на 11%. Авторы оговариваются, что данные шумные из-за машинного перевода, но эстонский с его богатой морфологией близок к русскому по задаче.
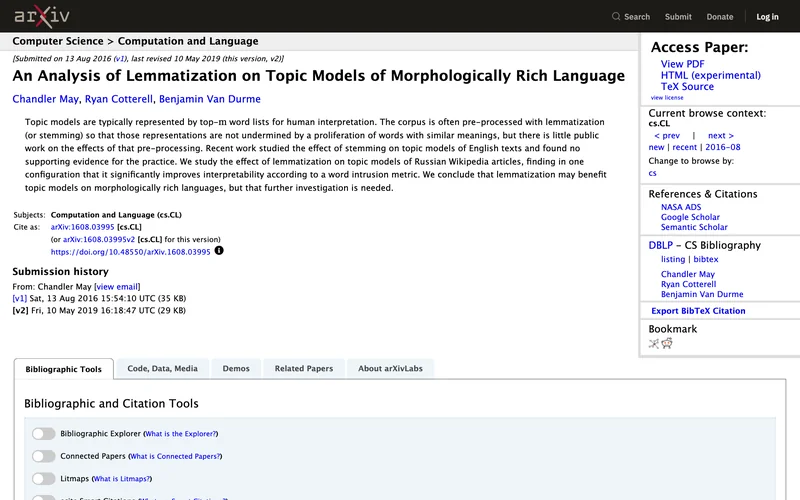
На русском материале проверяли тематические модели, которые вытаскивают из корпуса списки главных слов темы. В работе по русской Википедии лемматизация в одной из конфигураций заметно повысила понятность таких списков по метрике, где человек ищет лишнее слово. Авторы осторожны: для английского похожий опыт со стеммингом пользы не показал; для морфологически богатых языков нужны новые проверки.
Ошибки лемматизатора: омонимы, новые слова, выбор леммы
Омонимия ломает лемматизатор первой. В примере cropas.by «стекло» бывает предметом и прошедшим временем глагола «стечь», и без контекста выбрать нельзя. Новые слова вроде «гуглить» или «лайкнуть» могут отсутствовать в словарях, а имена, аббревиатуры и опечатки требуют отдельной обработки. На обычных текстах точность лемматизаторов по тем же данным составляет 95-99%, но в медицине, юриспруденции и программировании она ниже из-за специальной лексики.
Слабое звено часто в выборе нужной леммы из нескольких. Это показал разбор эстонского анализатора Vabamorf: по данным статьи про GliLem он выбирает лемму верно примерно в 89% случаев, а если засчитывать ответ, когда правильный вариант есть среди кандидатов, точность выше 99%. Разрыв сократили моделью, которая смотрит на контекст, и точность выбора поднялась с 89% до 97,7%.
На практике омонимы разбирают по соседним словам: в «купить стекло» речь о предмете, в «вода стекло по стене» о глаголе. Лемматизатор без такого контекста выберет наиболее частотный разбор, и в нише с редкой лексикой это будет ошибкой. Поэтому автоматически собранные леммы стоит просматривать глазами: пара минут на выборку из ядра экономит часы на исправлении кластеров.
Инструменты для лемматизации текста и семантики
Разработчику хватит готовых библиотек. Библиотека spaCy для русского лемматизирует через pymorphy3: в исходном коде русского лемматизатора есть режим pymorphy3, и для работы ему нужна установленная одноимённая библиотека. Вторая привычная связка для русского: pymorphy2 со словарём OpenCorpora и Mystem из Яндекса.
Цена классической морфологии заметна в продакшене. Сообщество MAWO, которое занимается русским NLP, рассказывает на Хабре, что pymorphy2 тратит 500 МБ оперативной памяти только на словари и 30-60 секунд на их загрузку из XML при старте. Для облачной функции такой холодный старт слишком долог, поэтому команда перевела словари на структуру DAWG. Загрузка ускорилась в 30 раз, а памяти стало уходить на 90% меньше: вместо минуты анализатор стартует за 1-2 секунды и разбирает 15-25 тысяч слов в секунду, раньше было около 12 тысяч. Это замеры самих авторов, поэтому на своих данных их стоит перепроверить.
Тем, кто не пишет код, подходят SEO-сервисы с лемматизацией семантического ядра, например Key Collector и Just-Magic. Есть вариант и для Excel: автор надстройки !SEMTools пишет, что она обрабатывает десятки тысяч строк в секунду, но к леммам приводит слова только в нижнем регистре, а пунктуацию считает частью слов.
Любой автоматический результат стоит проверить перед работой с ядром. Минимальный порядок такой:
- Приведите фразы к нижнему регистру и уберите пунктуацию до запуска лемматизации, иначе слова с запятой или заглавной буквой не распознаются.
- Отсортируйте результат по лемме и просмотрите группы, где слились фразы с разным смыслом: так находят склейки.
- Отдельно проверьте омонимы, бренды и аббревиатуры: лемматизатор мог разобрать их неверно или оставить как есть.
- Оставьте в ядре исходные фразы рядом с леммами, чтобы вернуться к точной форме запроса, если она понадобится.
- Сохраните список слов, которые лемматизатор оставил без изменений: среди них часто новые термины и названия брендов.
- Сравните число строк до и после: если дублей оказалось пятая часть списка и больше, проверьте, не слились ли разные по смыслу фразы.
- Запишите, какой лемматизатор и какой словарь вы использовали: при смене инструмента результат может отличаться.
Похожий приём годится и для готового текста. Прогоните статью через лемматизатор и посмотрите частоты лемм: если главная для темы лемма встречается реже второстепенной, акценты в тексте смещены. Если же одна лемма повторяется в каждом абзаце, текст читается как набор ключей, и его стоит переписать нормальным языком.
Лемма в SEO: семантика, Вордстат, уникальность
Первая выгода - чистая семантика. Вордстат считает запрос «с учётом всех возможных форм»: так сказано в справке Яндекса, поэтому фразу достаточно набрать в начальной форме. В собственном ядре формы приходится сводить самому. По описанию SEMTools, без лемматизации ядра есть риск не учесть фразы в менее популярных словоформах. Та же процедура убирает неявные дубли: четыре фразы в примере автора отличаются лишь формами слов, порядком и предлогом. Лемматизируют и вне SEO: социологи считают тональность и частоту терминов в транскриптах речей политиков, например послания президента к Федеральному собранию.
Как это выглядит в работе, показывает пример блога click.ru на Хабре. Авторы собрали ключи двумя подборщиками, по контенту сайта и по словам конкурентов, и получили 3492 фразы. Бесплатный нормализатор убирает дубли с учётом морфологии и перестановки слов: если в списке есть «купить samsung galaxy s10» и «samsung galaxy s10 купить», вторую фразу он удалит. После чистки списка от дублей и мусора осталось 2828 запросов, то есть дубликаты занимали 19% ядра.
Иногда словоформа как раз важна. В Вордстате для этого служит восклицательный знак: оператор фиксирует конкретную словоформу и отсекает остальные склонения и спряжения. Запрос «!сайта» покажет частоту только этой формы, и так видно, в каком падеже люди спрашивают чаще. В связке с другими операторами выборка становится точнее: запрос «( продвижение | оптимизация ) в google !сайта -топ» вернёт фразы с одним из двух слов, с «в google», только с формой «сайта» и без слова «топ». О том, как читать частотность, мы писали в материале про популярные поисковые запросы.
Вторая сфера - проверка уникальности. Сервисы сравнивают тексты по шинглам: так называют цепочки из 2-5 подряд идущих слов, приведённых к леммам. Из фразы «продвижение сайтов в поисковых системах» получается цепочка лемм «продвижение сайт поисковый система», и если такая же есть в чужом тексте, совпадение засчитают, даже когда формы слов совсем разные. Смена падежей не делает текст уникальным.
Третья область - написание текстов. По словам Ingate, поисковик воспринимает «продвижении» и «продвижение» как один сигнал, поэтому точную форму подбирать не нужно, достаточно присутствия нужной леммы. Плотность в 2-3% там называют ориентиром, а не целью: превышение сигнализирует поисковику об искусственной оптимизации. Общую схему работы со страницей мы описали в основах SEO-продвижения.
Частые вопросы
Что такое лемма простыми словами?
Лемма - это форма слова, под которой оно стоит в словаре. Для существительных это именительный падеж, для глаголов инфинитив, для прилагательных мужской род. Все остальные формы слова, от «сайтов» до «сайтам», относятся к одной лемме «сайт» и считаются одним словом, когда поисковик сопоставляет запрос со страницей.
Чем лемматизация отличается от стемминга?
Стемминг отрезает окончания по правилам и не заглядывает в словарь, поэтому может склеить разные слова или разделить родственные. Лемматизация использует словарь и морфологию и возвращает настоящую словарную форму. Она точнее, но требует больше ресурсов и хуже справляется со словами, которых нет в словаре.
Нужно ли вписывать ключевые слова в точной форме?
Обычно нет: поисковик приводит слова запроса и текста к леммам и сравнивает их. Важнее раскрыть тему и сохранить естественный язык. Точная форма нужна в отдельных случаях, например когда вы анализируете частотность именно этого падежа через оператор восклицательного знака в Вордстате.
Как лемматизировать семантическое ядро без программирования?
Подойдут SEO-сервисы со встроенной лемматизацией, такие как Key Collector и Just-Magic, или надстройка !SEMTools для Excel. Перед запуском приведите фразы к нижнему регистру и уберите пунктуацию, затем проверьте результат вручную: редкие слова и омонимы лемматизатор мог определить неверно.
Всегда ли лемматизатор прав?
Нет. Лемматизаторы ошибаются на омонимах вроде «стекло», на новых словах, именах и опечатках. Современные инструменты дают высокую точность на обычных текстах, но в медицине, юриспруденции и программировании она падает. Поэтому важные списки лемм полезно просматривать вручную и не принимать на веру.
Дата публикации:
Теги
Задать вопрос
Вопросы и ответы
Пока нет опубликованных вопросов. Задайте первый — после модерации он появится здесь.
Вам также может понравиться
Все статьи
SEO
SEO-продвижение: что это, как работает и сколько занимает
Что такое SEO-продвижение: как поисковик находит и оценивает страницы, этапы работ, устаревшие методы, сроки результата и примеры кейсов.
SEO
Как узнать популярные запросы: Вордстат, Trends, Вебмастер
Где смотреть популярные запросы в Яндексе и Google, как читать Вордстат и Trends, как найти запросы своего сайта и почему цифрам нельзя верить вслепую.
SEO
Индексация сайта: как работает, как проверить и ускорить
Что такое индексация сайта, как страница попадает в Яндекс и Google, как проверить статус в Вебмастере и Search Console и чем ускорить индексацию.
SEO
Яндекс Вебмастер: что это, как подключить и читать отчёты
Что такое Яндекс Вебмастер, как подключить сайт, какие отчёты открывать каждую неделю и что делать при выпадении страниц из поиска и переезде.