
Мета-теги: что читают Google и Яндекс и что можно не писать
Мета-теги - это служебные строки в коде страницы: посетитель их не видит, а поисковые роботы, браузеры и мессенджеры читают их первыми. Разбираем весь набор, от title и robots до viewport и Open Graph, и сверяем его со справкой Google и Яндекса, чтобы было понятно, что влияет на выдачу, а что просто лежит в коде.
Что такое мета-теги?
Мета-теги живут в разделе head кода страницы и дают сведения о странице то, чего нет в её тексте: в какой она кодировке, как масштабировать её на телефоне, можно ли её индексировать, как подписать ссылку на неё в мессенджере. Человек их не видит. Робот читает их раньше, чем доберётся до первого абзаца.
Слово «мета-тег» в быту шире, чем в стандарте. Строго говоря, title записывается отдельным элементом, а canonical это вообще link. Но проверять их удобнее одним списком, поэтому в этом разборе они стоят рядом. Тег description мы уже разобрали подробно в материале про мета-описание, поэтому здесь он встречается только в общей картине.
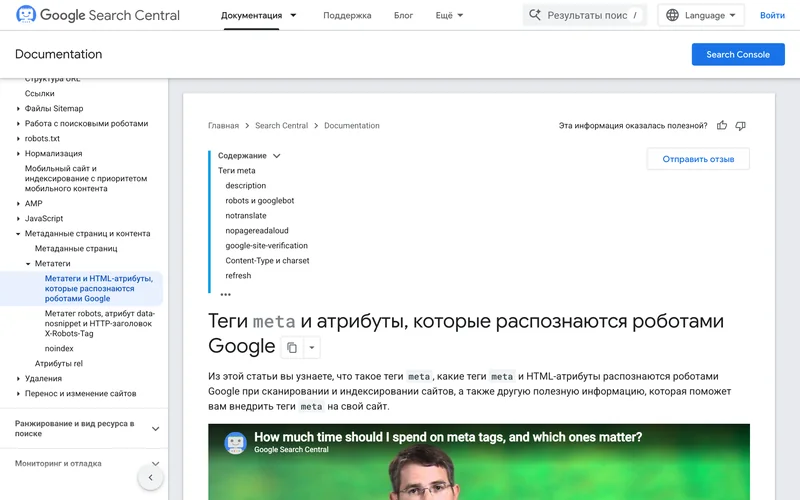
Главное, что стоит усвоить сразу: поисковик читает не всё, что вы положили в head. В справке для вебмастеров Google перечисляет теги, которые его роботы распознают: description, robots и googlebot, notranslate, nopagereadaloud, google-site-verification, content-type и charset, refresh, viewport и rating. Остальное он игнорирует, и сама справка прямо об этом предупреждает.
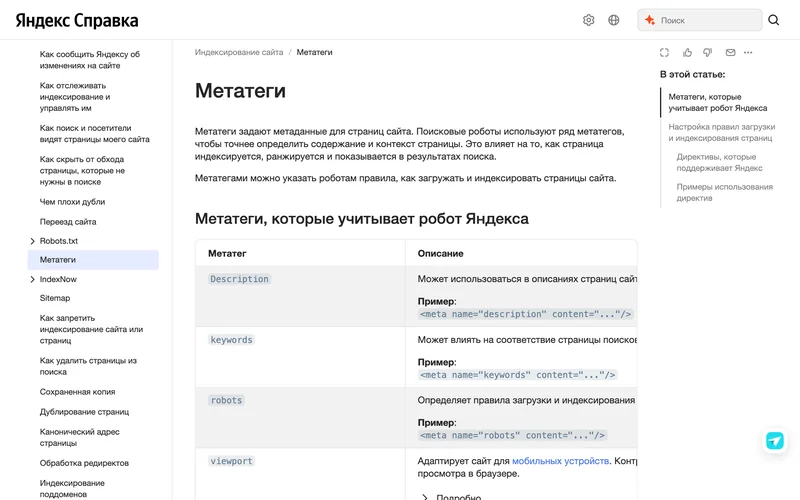
Яндекс называет свой набор в отдельной справке: description, keywords, robots, viewport, Content-Type и refresh, а ещё два служебных тега, которые скрывают страницу от тематических блоков «Услуги» и «Квартиры». Списки пересекаются почти полностью. Расходятся они в одном месте, о нём ниже.
Есть и общая оговорка. Как отмечают в блоге Adlook, мета-теги сами по себе не выводят сайт в топ: поисковики оценивают содержание, поведение посетителей и скорость загрузки. Теги задают рамку, в которой страница будет понята и показана. Остальные теги из общего набора HTML в выдачу не попадают.
Какие теги читают Google и Яндекс?
Чтобы не держать в голове два списка, соберём их в одну таблицу. Отметки взяты из справок обеих поисковых систем, без пересказов из чужих обзоров.
| Тег | Яндекс | Зачем нужен | |
|---|---|---|---|
| title | читает | читает | Заголовок результата и вкладки браузера |
| description | читает | читает | Кандидат на текст сниппета, ранжирование не меняет |
| keywords | не читает | учитывает при соответствии запросу | Ключевые слова страницы |
| robots | читает | читает | Правила индексации и обхода ссылок |
| viewport | читает | читает | Масштаб страницы на телефоне |
| charset, Content-Type | читает | читает | Кодировка и тип документа |
| refresh | читает, но не советует | читает как временный редирект | Переход на другой адрес через N секунд |
| canonical | читает | читает как рекомендацию | Предпочитаемый адрес страницы из группы дублей |
Заметное расхождение одно, и касается оно keywords. Google сообщил об этом ещё давно: тег не влияет на ранжирование. Яндекс в справке осторожнее: он пишет, что тег может влиять на соответствие страницы запросам. Слово «может» здесь ключевое, гарантий в нём нет.
В настоящее время они вообще не влияют на ранжирование
Мэтт Каттс, команда качества поиска Google, о теге keywords
Блог Google объясняет это на примере двух владельцев сайтов, Алисы и Бориса. Борис скопировал в свой keywords слова конкурентки и дописал туда название её компании. Алиса забеспокоилась, а команда качества поиска ответила коротко: нет, волноваться не стоит. Google Поиск тег игнорирует полностью, а учитывал такие теги только платный корпоративный продукт Search Appliance, не связанный с основным поиском. Причина отказа в том, что около десяти лет назад, когда страницы оценивали только по их содержимому, в тег стали набивать слова, которых на странице не было, и Google перестал его обрабатывать.
Google пошёл дальше и сам составил список отключённых тегов. В нём keywords, атрибут lang, ссылки rel next и prev, а также правило nositelinkssearchbox. Если в шаблоне вашей CMS всё это ещё стоит, вреда нет, но и пользы тоже. Время лучше потратить на title и robots.
Как title управляет тем, что видят в выдаче
Из всех тегов title ближе всего к деньгам: по нему человек решает, открывать ли страницу. Справка Google просит давать каждой странице свой заголовок, короткий и информативный, без размытых формулировок вроде «Главная страница». Длина не ограничена, но результат обрезается под ширину экрана.
Как часто Google вмешивается, показало исследование Zyppy. Его авторы сверили более 80 тысяч заголовков с 2370 сайтов с тем, что реально показано в поиске. Google, по данным Search Engine Journal, хотя бы частично переписал 61,6% заголовков. Хуже всего пришлось крайностям: длиннее 70 символов поменяли 99,9% заголовков, а короче шести символов 96,6%.
Для заголовков длиной 51-60 символов, по данным того же исследования, вероятность правки падала до 39-42%. Пример из материала Zyppy показывает механику. Вымышленная компания по продаже мороженого с черничными леденцами забыла обновить заголовок главной, и там осталось одно слово «Home». Google в таком случае показывает название компании, потому что человек, ищущий это мороженое, иначе не узнал бы результат.
Формальные мелочи тоже влияют. По тем же данным Zyppy, квадратные скобки Google переписывал в 77,6% случаев, а круглые в 61,9%. Дефис в роли разделителя он убирал в 19,7% случаев, вертикальную черту в 41%. Если заголовок совпадал с H1, правок становилось заметно меньше: по подсчёту Search Engine Journal, до 20,6%.
- держите заголовок в пределах 51-60 символов;
- ставьте в начало главный запрос, а название компании в конец;
- вместо скобок пишите круглые скобки, вместо черты ставьте дефис;
- приводите H1 и title к близкой формулировке;
- не повторяйте один заголовок на разных страницах;
- не сокращайте заголовок до одного слова вроде «Главная».
С описанием проще. Google берёт его, только когда оно точнее отвечает на запрос, чем текст страницы, поэтому формулу для description и примеры мы здесь не повторяем.
Как закрыть страницу через robots и не потерять весь сайт?
Мета-тег robots задаёт правила индексации. Если вы вообще его не пишете, ничего не ломается: по справке Google значения index и follow действуют по умолчанию. В таблице Яндекса такая же логика: разрешающие директивы робот использует сам, а при конфликте они сильнее запрещающих.
Есть две важные детали. Первая: теги robots и googlebot можно задать одновременно, и Google применит более строгое правило. Вторая: если страницу закрыли в файле robots.txt, робот не загрузит её и не прочитает noindex. Об этом прямо сказано в справках Яндекса и Google. Поэтому закрывать и там и там не нужно: noindex сработает только на странице, которую робот может открыть.
Как дорого обходится ошибка с noindex, видно по рассказу специалиста агентства Brafton в блоге Moz. В четверг вечером после релиза тег ушёл на каждую страницу сайта. В воскресенье утром он увидел, что позиции исчезли целиком, и это было не колебание выдачи. Алгоритм поисковика к этому отношения не имел: страницы пропали из индекса.
Разработчик откатил релиз, специалист перестроил карту сайта и вручную просил обход главных страниц. За первую неделю поиск потерял 33,2% трафика. Search Console видел максимум 249 проблемных страниц из более чем 8000, то есть отставал от реальности. Видимость в поиске вернулась к исходной через шесть недель, а полностью страницы переиндексировались за восемь-девять. Одна коммерческая страница не возвращалась в индекс около двух месяцев, хотя автор перепробовал всё, от проверки URL до обновления даты.
После каждого релиза стоит пройти короткий порядок действий:
- откройте исходный код шаблона и найдите noindex;
- проверьте заголовок X-Robots-Tag, он действует так же, как тег;
- загляните в robots.txt и убедитесь, что там нет Disallow на весь сайт;
- проверьте главную и пару внутренних страниц в Search Console или Яндекс Вебмастере;
- через сутки после релиза сверьте в панелях вебмастера число страниц в поиске с прежним.
Тегом robots можно не только закрывать, но и дозировать показ. Google поддерживает правила nosnippet, max-snippet и max-image-preview, которые ограничивают длину текста и размер картинки в результате. Полный список значений есть в справке Google по robots. Подробнее про то, как страницы попадают в индекс, мы писали в разборе индексации сайта.
Viewport, charset и refresh: что нужно каждой странице?
Эти три тега ничего не продвигают, но без них страница может ломаться. Начнём с viewport. Яндекс объясняет, что без него мобильные браузеры показывают версию для компьютера и пытаются уместить её на узкий экран: увеличивают шрифт, масштабируют или показывают только часть содержимого. Значения width=device-width и initial-scale=1 решают это: ширина берётся с экрана устройства, масштаб остаётся один к одному.
Google смотрит на этот тег как на признак. По его справке наличие viewport говорит, что страница оптимизирована для мобильных устройств. Тег работает только вместе с адаптивной вёрсткой: если её нет, браузер покажет одну десктопную версию. Подробно про устройство мобильных страниц рассказано в разборе мобильной версии.
Кодировка задаётся тегом charset. MDN просит ставить его внутри head и в первых 1024 байтах страницы: часть браузеров читает только их, прежде чем выбрать кодировку. Google при этом по возможности советует UTF-8. Там же сказано, что заголовок Content-Type от сервера и метка порядка байтов перекрывают этот тег: если сервер отдаёт другую кодировку, ваша строка не сработает. Поэтому ставьте meta charset первой строкой head, до title, и сверяйте её с ответом сервера.
С refresh осторожнее. Яндекс относит его к временным редиректам вроде кодов 302, 303 и 307 и допускает при переезде. Google замечает, что поддерживают его не все браузеры и он может запутать пользователя, и советует вместо него серверную переадресацию с кодом 301. Мы разбирали это в материале про редиректы: серверный ответ надёжнее любой строки в head.
Canonical и Open Graph: теги для дублей и для ссылок в соцсетях
Тег canonical на деле записывается как link, но работает в той же логике. Он называет предпочтительный адрес из группы дублей. Google объясняет, зачем: сигналы вроде ссылок собираются на одном URL. В его примере карточка зелёного платья открывается и по чистому адресу, и по адресу с меткой рекламы gclid. Если каноническим назначен чистый, все внешние ссылки на вариант с меткой засчитываются ему, а сам он остаётся тем адресом, который видит покупатель в выдаче.
Без указания Google выберет адрес сам. Яндекс предупреждает: для него canonical только рекомендация, и робот может её отклонить, например если содержимое страниц сильно отличается. Для переезда на защищённый протокол Яндекс рекомендует редирект: для таких адресов rel canonical больше не поддерживается.
Теперь соцсети. Когда вы вставляете ссылку в сообщение, превью собирается из тегов Open Graph. По описанию протокола, обязательных свойств четыре:
- og:title - название объекта;
- og:type - тип, например video.movie;
- og:image - адрес картинки;
- og:url - канонический адрес, постоянный идентификатор страницы.
В качестве образца протокол берёт страницу фильма The Rock на IMDb. В title самой страницы к названию дописан год выпуска, а в og:title стоит чистое «The Rock», чтобы карточка в соцсети выглядела аккуратно. og:type там равен video.movie, og:url ведёт на постоянный адрес фильма с номером tt0117500, og:image на постер. Среди необязательных тегов есть og:description и og:site_name, а к картинке рекомендуют добавлять og:image:alt с описанием того, что на ней нарисовано.
Работает это шире, чем кажется. Стандарт Open Graph поддерживают VK и Telegram. Задайте og:image явно, иначе выбор картинки для превью остаётся за соцсетью. Вставьте свою ссылку в сообщение себе и убедитесь, что карточка выглядит так, как задумано.
Как проверить теги и что можно не писать?
Проще всего начать без инструментов. Откройте страницу, нажмите Ctrl+U и найдите в коде слово meta: все теги лежат в head. Для своего сайта точнее покажут инструменты поисковиков. В Яндекс Вебмастере раздел «Индексирование» → «Заголовки и описания» показывает, как система видит title и description, и ищет дубли. Подробнее об этом сервисе мы писали в разборе Яндекс Вебмастера.
В Google Search Console откройте «Проверку URL», введите адрес и нажмите «Проверить опубликованную версию», затем вкладку с HTML-кодом. Так вы увидите страницу глазами робота, включая title, description и og-теги. Если страниц сотни, подойдёт Screaming Frog SEO Spider: бесплатная версия проверяет до 500 страниц.
Теперь о том, что можно не писать. Если на странице нет контента для взрослых, тег rating не нужен: Google предлагает его для пометки таких страниц. Тег keywords Google игнорирует, а в Яндексе его вес оговорён неопределённо. Теги, которых нет в справках обеих систем, поисковики пропустят.
Минимальный набор для обычной страницы выглядит так:
- charset первой строкой head;
- viewport для адаптивной страницы;
- уникальные title и description;
- canonical, если у страницы бывают дубли;
- четыре обязательных тега Open Graph;
- robots только на страницах, которые нужно закрыть.
Этого набора хватает и для поиска, и для аккуратных превью в мессенджерах.
Частые вопросы
Какие мета-теги нужны каждой странице?
Обязательный минимум: charset, viewport, title и description. Canonical пригодится, если у страницы есть дубли с другим адресом, а robots нужен только для закрытия от индекса. Теги Open Graph задают карточку ссылки в мессенджере и соцсетях. Остальные теги добавляйте под конкретную задачу, а не по привычке.
Влияет ли тег keywords на ранжирование?
Google не учитывает этот тег ни при индексировании, ни при ранжировании. Яндекс в справке пишет, что тег может влиять на соответствие страницы запросам, но гарантий не даёт. Если вы всё же заполняете keywords, вписывайте только слова, которые реально есть на странице, и не тратьте на тег много времени.
Чем title отличается от H1?
Title показывается в результате поиска и на вкладке браузера, а H1 виден только внутри самой страницы. Google может подменить title заголовком H1, если title выглядит слишком рекламным. Когда формулировки близки, поисковик реже переписывает заголовок в выдаче, поэтому держите их согласованными.
Как закрыть страницу от индексации тегом?
Добавьте в head строку meta name robots со значением noindex или none. Значение noindex понятно обоим поисковикам, а none означает noindex вместе с nofollow. Не закрывайте страницу ещё и в robots.txt: робот не загрузит её и не увидит тег, поэтому страница может остаться в поиске.
Зачем нужен тег viewport?
Он сообщает мобильному браузеру ширину и масштаб страницы. Без него браузер покажет версию для компьютера, уменьшенную до размеров экрана, и текст придётся увеличивать пальцами. Стандартная запись содержит width=device-width и initial-scale=1, а работает она только вместе с адаптивной вёрсткой страницы.
Дата публикации:
Теги
Задать вопрос
Вопросы и ответы
Пока нет опубликованных вопросов. Задайте первый — после модерации он появится здесь.
Вам также может понравиться
Все статьи
SEO
Meta description: что это, какой длины бывает и как писать
Что такое meta description, как поисковики формируют описание в выдаче, какой длины оно бывает, как писать описание для кликов и что показали тесты.
SEO
Теги HTML: что это, какие бывают и как влияют на SEO сайта
Теги HTML простыми словами: как устроены, какие группы бывают, как title, description, canonical и разметка влияют на сниппет, клики и позиции сайта.
SEO
Индексация сайта: как работает, как проверить и ускорить
Что такое индексация сайта, как страница попадает в Яндекс и Google, как проверить статус в Вебмастере и Search Console и чем ускорить индексацию.
SEO
Яндекс Вебмастер: что это, как подключить и читать отчёты
Что такое Яндекс Вебмастер, как подключить сайт, какие отчёты открывать каждую неделю и что делать при выпадении страниц из поиска и переезде.