
Как закрыть сайт от индексации: способы и типичные ошибки
Закрыть сайт от индексации можно несколькими способами, и делают они разное: одни не пускают робота к странице, другие дают её прочитать, но просят не показывать в поиске, третьи прячут её за паролем. Если выбрать не тот способ, страница всё равно окажется в выдаче. Разбираем, что подходит для черновика, служебных разделов и уже проиндексированных адресов.
Чем запрет сканирования отличается от запрета индексации?
Робот делает два разных шага: сначала заходит на адрес и читает его, потом решает, класть ли страницу в базу поиска. Закрыть можно любой из шагов, и от выбранного зависит результат. Файл robots.txt работает на первом шаге, директива noindex на втором, а пароль закрывает сам вход.
Отсюда главное правило всей темы: чтобы убрать страницу из поиска, роботу нужно дать её прочитать и увидеть запрет. Как адрес проходит путь от обнаружения до выдачи, мы разбирали в статье про индексацию сайта, поэтому здесь только то, что касается запретов.
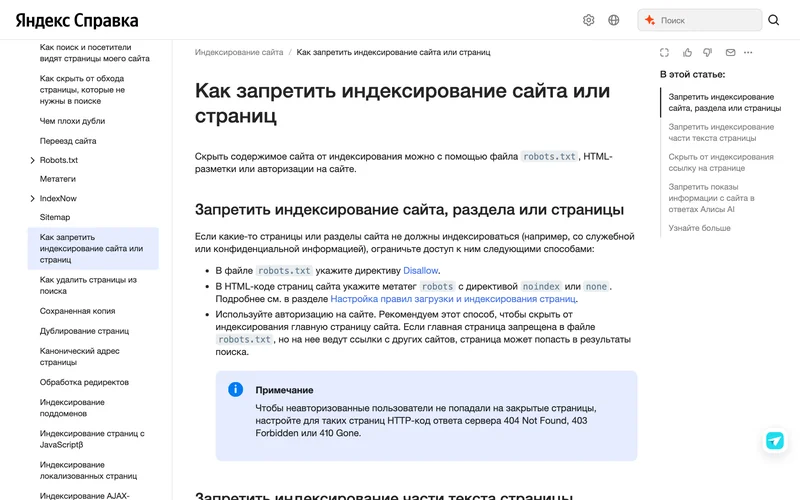
Google в справке прямо пишет, что robots.txt не предназначен для запрета показа материалов в поиске: для этого служат noindex и пароль. У Яндекса список шире: директива Disallow в robots.txt, метатег robots со значением noindex или none и авторизация. Сводка по способам ниже, подробности в следующих разделах.
| Способ | Что делает | Когда выбирать |
|---|---|---|
| Disallow в robots.txt | Не пускает робота к адресу, но сам адрес может остаться в выдаче | Служебные разделы и дубли, которые не нужно сканировать |
| Метатег robots с noindex | Страница читается, но в выдачу не попадает | Обычные HTML-страницы, которые нужно убрать из поиска |
| Заголовок X-Robots-Tag | То же, что метатег, но на уровне ответа сервера | PDF, изображения, видео и всё, где нет HTML |
| Пароль или авторизация | Робот не видит содержимое вообще | Черновики, тестовые сайты, личные кабинеты |
| Коды 404, 410 | Сообщают, что страницы нет | Удалённые страницы |
Где хватает robots.txt и где он подводит
Файл robots.txt хорош для двух задач: снизить нагрузку от роботов и не тратить их время на мусор. Яндекс советует закрывать директивами только служебные и дублирующие страницы, а размер файла держать до 500 КБ: роботы корректно обрабатывают файлы не больше этого.
Подвох в том, что запрет сканирования не равен запрету показа. По словам Google, страницы, закрытые в robots.txt, всё равно могут показываться в результатах поиска, но без описания. Яндекс предупреждает так же: ограниченные в robots.txt страницы могут участвовать в поиске. Типичная картина: на закрытый адрес ссылаются с другого ресурса, и поисковик показывает голый заголовок без текста.
Хуже всего получается, когда запрет сочетают с noindex. Робот не может открыть страницу, поэтому и тег не увидит. Справка Google называет это одной из причин, почему адрес остаётся в выдаче: robots.txt не даёт Googlebot обнаружить метатег. Яндекс требует того же: страницы с noindex нельзя ограничивать в robots.txt, иначе робот не найдёт указание.
Показателен случай с самим noindex. Многие вебмастера писали его прямо в robots.txt, хотя правило никогда не было описано в документации Google, и работало оно по недоразумению. Изучив файлы, Google выяснил, что такие правила не противоречат другим директивам лишь примерно в одном файле из ста тысяч (0,001%), а путаница вредила присутствию сайтов в поиске. Поэтому компания предупредила заранее и выключила обработку в назначенный день, и запреты в robots.txt перестали работать.
перестаем использовать весь код, который обрабатывает неподдерживаемые и неопубликованные правила
Гэри Ийеш, Google, в блоге Search Central
Noindex в теге и в заголовке: как это работает
Директива noindex живёт в двух местах: метатег robots в разделе head страницы или HTTP-заголовок X-Robots-Tag. Работают они одинаково. Если Googlebot находит такой тег или заголовок, он игнорирует страницу, даже когда на неё ссылаются другие ресурсы. Поэтому для обычной страницы, которую нужно убрать из поиска, это основной инструмент.
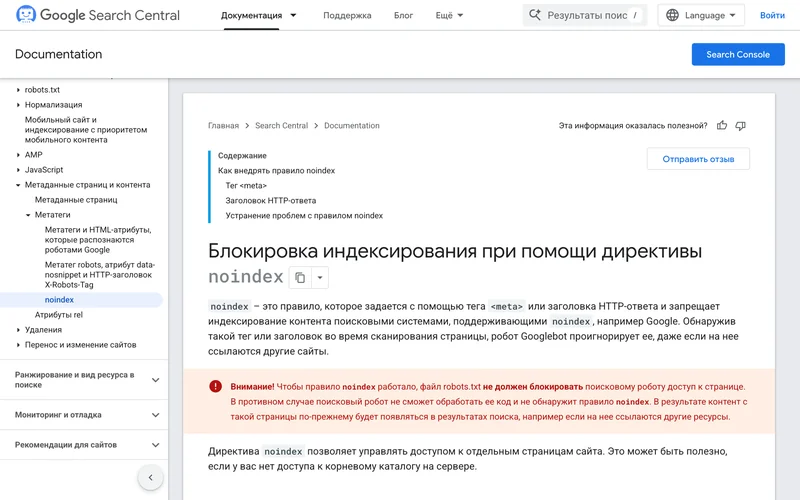
Заголовок выручает там, где HTML нет. Google рекомендует его для PDF, видео и изображений, а Яндекс позволяет задать X-Robots-Tag для отдельного адреса на стороне сервера. Настраивает его тот, кто отвечает за веб-сервер: в nginx это одна строка в конфигурации нужного раздела.
У значения none есть особенность: по справке, оно действует как noindex вместе с nofollow, то есть закрывает и страницу, и ссылки на ней. Если нужно убрать только страницу и оставить ссылки, пишите noindex отдельно.
Учтите ещё два нюанса. Тег для всех роботов не заденет рекламного бота: для AdsBot-Google нужны отдельные правила. Кроме того, некоторые поисковые системы по-другому понимают noindex и могут показать такую страницу, поэтому для нужного вам поисковика проверяйте справку отдельно.
Результата сразу не ждите. Если страница продолжает появляться в выдаче, робот скорее всего её ещё не перечитал. Повторно он может прийти только спустя несколько месяцев. Ускорить помогает инструмент проверки URL в Search Console и раздел индексирования в Яндекс Вебмастере.
Черновик и тестовую версию прячут за паролем
Надёжный способ без дыр для закрытого содержимого: пароль. Google отмечает, что при блокировке доступа паролем страница в большинстве случаев будет удалена из индекса. Яндекс идёт дальше и рекомендует авторизацию для главной страницы: на неё чаще всего ссылаются снаружи, и запрет в robots.txt её не спасает.
Поучительный случай описал SEO-специалист из Polemic Digital. Следя за конкурентами, он увидел, что у одного веб-агентства тестовый поддомен с клиентскими макетами проиндексировал Google: его можно было найти обычным поиском по оператору site. В тестовых версиях лежат недоделанные макеты и черновой текст, а открытый доступ к ним, по словам автора, может навредить бизнесу клиента. Название агентства автор скрыл и написал ему лично, чтобы клиенты не пострадали из-за чужой оплошности.
Там же он объясняет, почему одного robots.txt мало: поддомен всё равно может попасть в выдачу, если кто-то на него сослался. Надёжнее сочетать пароль с заголовком X-Robots-Tag, включённым только на тестовом сервере. Так при запуске не нужно ничего снимать, и нет риска забыть убрать тег после релиза.
Пароль настраивают в панели хостинга или в конфигурации сервера. Закрытые страницы для постороннего посетителя лучше отдавать с кодом, который объясняет роботу ситуацию. Яндекс советует для таких адресов коды 404, 403 или 410 (подробнее про ошибку 404 в отдельной статье).
Как убрать из поиска то, что уже туда попало?
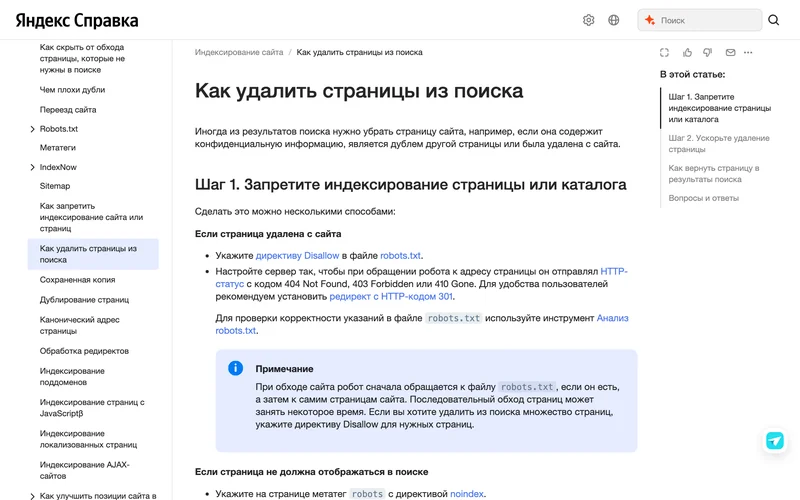
Порядок действий всегда один: сначала запрет, потом ускорение. Так устроена и инструкция Яндекса: шаг первый закрывает страницу, шаг второй ускоряет удаление. Сроки зависят от способа, и ждать нужно по-разному.
| Способ в Яндексе | Что произойдёт |
|---|---|
| Disallow в robots.txt | Страница уходит из базы в течение недели после того, как робот увидит запрет, но изредка может мелькать в выдаче из-за внешних ссылок |
| Коды 404, 403 или 410 | Удаление в течение недели после обнаружения |
| Метатег noindex | Адрес появится в списке исключённых в Вебмастере |
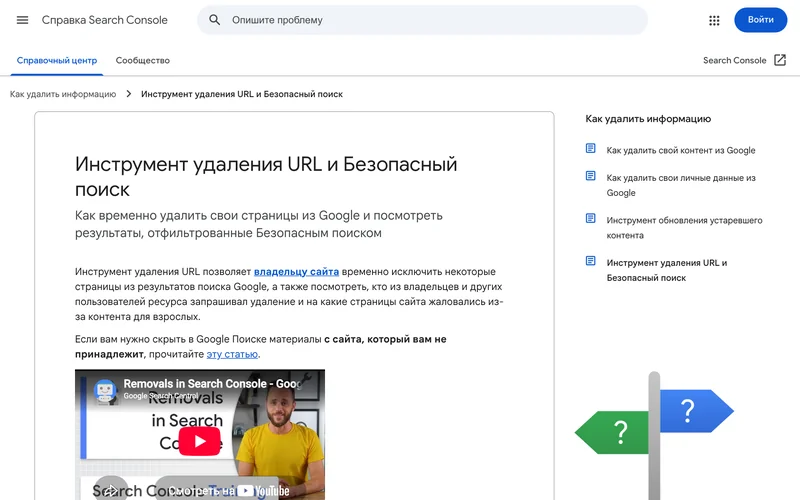
В Google есть инструмент удаления URL в Search Console, но он действует до шести месяцев. Чтобы исключить страницу из выдачи Google окончательно, к инструменту добавляют код 404 или 410, пароль и тег noindex.
Цена ошибки хорошо видна на примере ChatGPT. Пользователи могли нажать «поделиться» и поставить галочку, чтобы чат нашли поисковики. Журналисты Fast Company нашли более 4500 общих ссылок ChatGPT в индексе Google, а в чатах попадались имена, резюме и рабочие материалы. OpenAI убрала опцию и стала вычищать ссылки из поиска, объяснив, что она давала слишком много шансов поделиться лишним.
Из этой истории стоит запомнить деталь: удаление разговора из истории не убирает публичную ссылку и не вычищает её из поиска. Так же и у вас: если удалить страницу из админки, но оставить её адрес доступным и без запрета, поисковик ещё долго будет о ней помнить.
Другая показательная история случилась с WhatsApp (принадлежит Meta, организации, деятельность которой запрещена в России как экстремистская). Журналист Джордан Вилдон заметил, что ссылки-приглашения в групповые чаты индексирует Google и находит по запросу с оператором site. Под угрозой оказались, по оценкам прессы, около 470 тысяч чатов. Ссылку, которой делились как личной, поисковик обработал как любую публичную страницу.
На работающем проекте закрывают дубли и технический шум
На работающих проектах чаще закрывают дубли и технический шум. Агентство SEOHead в разборе тега noindex описывает магазин электроники, где каждая комбинация фильтров получала свой адрес. В индексе накопилось более 38 000 дублирующих страниц, позиции падали. После noindex на фильтрах и canonical на основные категории, по данным агентства, индекс сократился на 72%, а трафик ключевых страниц вырос на 41% за три месяца.
Второй пример агентства SEOHead про UTM-метки. Из-за них на каждую статью приходилось до 12 версий адреса, и поисковик не понимал, какая основная. Агентство закрыло такие страницы и поставило canonical: по его данным, CTR вырос на 27%, а время визита на 34%.
Третий пример SEOHead касается внутреннего поиска: страницы выдачи по запросу попадали в индекс и занимали места под ключевыми запросами, пользователи с них уходили. После закрытия через noindex и ссылки на основной раздел, по сообщению агентства, конверсия выросла на 19%. Все три цифры агентство приводит о собственных проектах, так что считайте их ориентиром для проверки гипотезы.
Закрывать можно и части страницы. В Яндексе есть элемент noindex для фрагмента текста, а для ссылок подходят значения rel: ugc для пользовательских, sponsored для рекламных и nofollow для остальных. Если не хотите, чтобы материалы попадали в ответы Алисы AI, добавьте запрет для робота YandexAdditional в robots.txt: изменение учитывается за 2-14 дней.
Какие ошибки встречаются чаще всего?
Почти все провалы сводятся к нескольким повторяющимся ситуациям. Перед каждым релизом полезно пройти по этому списку и открыть живые адреса вместо настроек в админке.
- Запрет в robots.txt и noindex на одной странице: робот не увидит тег, и адрес останется в выдаче.
- Надежда, что Disallow мгновенно уберёт страницу: Яндексу нужна неделя после обнаружения запрета, а Google может показывать адрес без описания.
- Замок только на главной через robots.txt, хотя на неё ведут ссылки: для такой страницы нужна авторизация.
- Тестовый запрет, забытый после релиза: страницы живого проекта уходят из поиска, а посетители этого не замечают.
- Инструмент удаления считают окончательным: через шесть месяцев страница может вернуться.
- Закрытые адреса остались в карте сайта: уберите их оттуда, чтобы робот не получал противоречивых сигналов.
- Файл robots.txt больше 500 КБ или лежит не в корне: роботы Яндекса корректно обрабатывают файл не больше этого размера.
Бывает, что запрет поставили без вашего ведома. Яндекс в таблице причин исключения советует: если вы сами не размещали запрет, обратитесь к хостинг-провайдеру или регистратору и уберите запрещающие директивы. Проверьте это после переезда или смены панели хостинга: открывайте robots.txt первым делом.
Проверка занимает несколько минут. Откройте robots.txt в корневом каталоге и убедитесь, что сервер отвечает кодом 200 OK. Затем посмотрите исходный код нужной страницы и заголовки ответа: noindex должен быть там, где вы его ожидаете, и только там. Наконец, спросите у Вебмастера и Search Console про один закрытый и один открытый адрес и сравните статусы.
Если после этого страница всё равно остаётся в выдаче, значит, запрет не дошёл до робота или ссылка на адрес живёт на внешнем ресурсе. Начните с вопроса, видит ли робот страницу, и только потом меняйте способ закрытия. Общие принципы работы поиска собраны в разборе основ SEO-продвижения.
Частые вопросы
Сколько ждать, пока закрытая страница исчезнет из выдачи?
Зависит от поисковика и способа. Яндекс обещает удаление в течение недели после того, как робот обнаружит запрет или код 404, 403 либо 410. У Google срок определяется следующим визитом робота: он может прийти и через несколько месяцев, поэтому ускоряйте переобход через инструмент проверки URL.
Можно ли закрыть от индексации только часть текста?
В Яндексе можно: оберните нужный фрагмент элементом noindex или его комментарной формой, и текст не попадёт в индекс. Для ссылок подходят значения rel. Так прячут служебные вставки и рекламные блоки. Для Google такие элементы не описаны, поэтому для него закрывайте всю страницу или подгружайте блок отдельно.
Что делать, если закрытая в robots.txt страница осталась в поиске?
Уберите запрет из robots.txt, добавьте на страницу noindex и дайте роботу её перечитать. Пока доступ закрыт, поисковик не увидит тег и может держать адрес в выдаче по внешним ссылкам. Когда страница исчезнет, при необходимости снова закройте раздел в robots.txt, чтобы снизить нагрузку.
Чем noindex отличается от nofollow?
Noindex запрещает показывать саму страницу в выдаче. Nofollow относится к ссылкам: робот не должен переходить по ним или учитывать их. В метатеге их можно объединять, значение none включает оба. Для отдельной ссылки используют атрибут rel, у Яндекса есть и значения ugc и sponsored.
Как скрыть сайт от ответов Алисы AI?
Добавьте в robots.txt запрет для робота YandexAdditional или YandexAdditionalBot. Яндекс пишет, что изменение учитывается по мере обновления поисковых данных и занимает от двух до четырнадцати дней. Обычная индексация при этом задаётся отдельно, через noindex, пароль или Disallow для основного робота.
Дата публикации:
Теги
Задать вопрос
Вопросы и ответы
Пока нет опубликованных вопросов. Задайте первый — после модерации он появится здесь.
Вам также может понравиться
Все статьи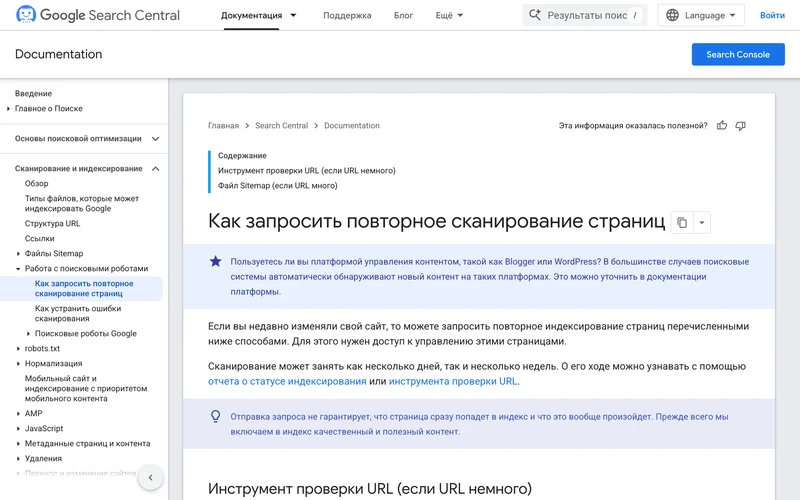
SEO
Индексация сайта: как работает, как проверить и ускорить
Что такое индексация сайта, как страница попадает в Яндекс и Google, как проверить статус в Вебмастере и Search Console и чем ускорить индексацию.
SEO
Яндекс Вебмастер: что это, как подключить и читать отчёты
Что такое Яндекс Вебмастер, как подключить сайт, какие отчёты открывать каждую неделю и что делать при выпадении страниц из поиска и переезде.
SEO
SEO-продвижение: что это, как работает и сколько занимает
Что такое SEO-продвижение: как поисковик находит и оценивает страницы, этапы работ, устаревшие методы, сроки результата и примеры кейсов.
SEO
Редирект: что это, виды 301 и 302, как настроить и проверить
Что такое редирект, чем отличаются 301, 302 и 303, как настроить его на сервере и в CMS, проверить и не потерять трафик при переезде сайта.